AI ajanları kod yazıyor, peki güvenliği kim düşünüyor?
Claude Code, Cursor, Codex gibi AI ajanları artık günlük işimin bir parçası. Daha önce bu konuda bir yazı paylaşmıştım ama orada daha çok "nerede hızlandırıyor, nerede yanıltıyor" sorusuna odaklanmıştım. Bu yazıda tek bir konuya iniyorum: AI ajanlarıyla kod yazarken güvenliği nasıl sağlıyorum?
Bunu teorik anlatmak yerine, bu sitenin kendi içinde çalışan gerçek bir özellik üzerinden anlatacağım: AI Check — metinlerde yapay zeka yazımı işaretlerini analiz eden, tamamen yerel çalışan araç. Bu özelliği kurarken karşılaştığım gerçek güvenlik kararlarını, aldığım önlemleri ve AI'ya nerede güvenip nerede güvenmediğimi paylaşıyorum.
AI ajanlarının gerçekten yardımcı olduğu yer
Önce dürüst olalım: bir AI ajanına "güvenli bir dosya yükleme sistemi yaz" dediğinizde, size çalışan bir taslak verir. Ama bu taslak genellikle "mutlu yol" (happy path) için yazılmıştır — kullanıcı doğru boyutta, doğru formatta bir dosya yüklediğinde çalışır. Kötü niyetli bir kullanıcı ne yapar, sistem kaynaklarını nasıl tüketir, hangi sınır değerler aşılabilir — bunlar genellikle ayrıca sorulması gereken sorulardır.
Benim yaklaşımım şu: AI ajanından önce tehdit modelini birlikte çıkarmasını istiyorum, sonra kodu. "Bu özelliği kötüye kullanmanın yolları neler olabilir?" sorusu, "bu özelliği nasıl yazarım?" sorusundan önce gelmeli.
1. SSRF saldırılarına karşı savunma
AI Check'in "site bağlantısı" modu, kullanıcının verdiği bir URL'yi sunucu tarafında okuyor. Bu, klasik bir Server-Side Request Forgery (SSRF) riski taşır: kötü niyetli biri http://169.254.169.254/ (bulut sağlayıcı metadata servisi) veya http://localhost:5432 gibi bir adres verip, sunucunun kendi iç ağına veya kendisine istek atmasını sağlayabilir.
Burada AI'nın ilk önerisi genellikle basit bir regex kontrolüydü: "localhost" veya "127.0.0.1" string'ini reddet. Bu, gerçek bir güvenlik önlemi değil — 2130706433 (127.0.0.1'in ondalık karşılığı), 0x7f000001 (onaltılık karşılığı) veya bir DNS kaydı üzerinden yönlendirme gibi onlarca yöntemle atlatılabilir.
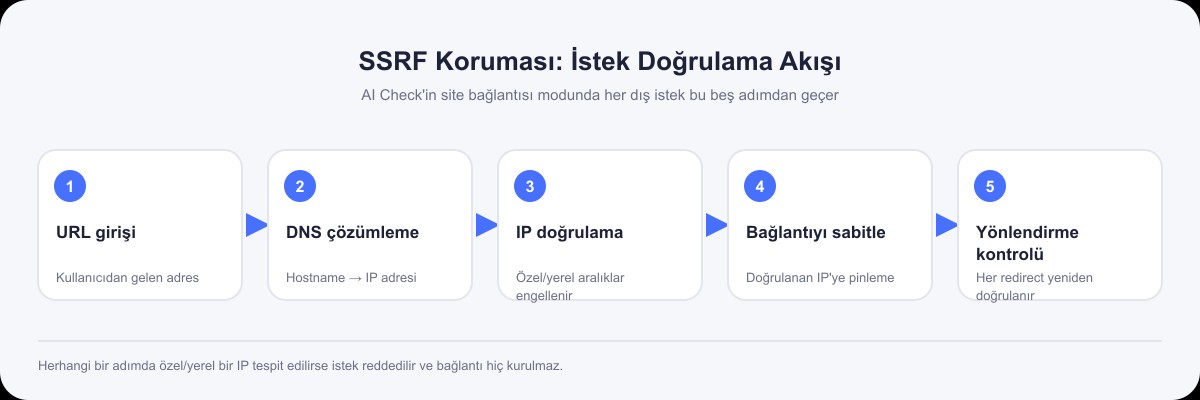
Gerçek çözüm şu adımları içeriyor:
- DNS'i önce çözüp, IP'yi doğrulamak — hostname değil, gerçek IP adresi kontrol edilmeli.
- Doğrulanan IP'ye bağlantıyı sabitlemek (pinning) — çünkü DNS çözümlemesi ile asıl bağlantı arasındaki milisaniyelerde kayıt değişebilir (TOCTOU — time-of-check to time-of-use açığı).
- Her yönlendirmeyi (redirect) yeniden doğrulamak — ilk adres güvenli olsa bile, sunucu sizi güvenli olmayan bir adrese yönlendirebilir.
- Özel/yerel IP aralıklarının tamamını engellemek — sadece
127.0.0.1değil;10.0.0.0/8,172.16.0.0/12,192.168.0.0/16, link-local (169.254.0.0/16) ve IPv6 karşılıkları dahil.
const addresses = await dns.lookup(hostname, { all: true });
if (addresses.some((a) => !isPublicAddress(a.address))) {
  throw new Error("Bu bağlantıya erişime izin verilmiyor.");
}
// Bağlantıyı DOĞRULANAN IP'ye sabitle — hostname'e değil
const response = await request(url, {
  lookup: (_host, _opts, callback) => callback(null, addresses[0].address),
});
Bu noktada AI ajanına güvendim ama ilk önerisine değil, üçüncü önerisine. İlk ikisi "çalışıyor" görünüyordu; sadece belirli saldırı senaryolarını sorduğumda gerçek zayıflıklar ortaya çıktı.
2. Zip-bomb ve dosya boyutu sınırları
Belge yükleme özelliğinde DOCX dosyaları kabul ediyoruz. DOCX aslında bir ZIP arşividir — ve ZIP formatının bilinen bir zayıflığı var: sıkıştırma oranı saldırısı (zip bomb). Birkaç kilobaytlık bir dosya, açıldığında gigabaytlarca veriye genişleyebilir ve sunucunun belleğini tüketebilir.
Naif bir yaklaşım, dosyayı önce tamamen açıp sonra boyutunu kontrol etmektir — ama bu noktada zarar çoktan verilmiştir. Doğru yaklaşım, ZIP'in merkezi dizinini (central directory) açmadan önce incelemek: her girişin sıkıştırılmamış boyutunu ZIP meta verisinden okuyup, toplam genişleyecek boyutu ve girdi sayısını hesaplayıp, bir eşiği aşarsa dosyayı hiç açmadan reddetmek.
// PK\x01\x02 imzasını tarayıp açmadan boyut hesapla
for (let i = 0; i + 46 <= buffer.length; i++) {
  if (buffer.readUInt32LE(i) !== 0x02014b50) continue;
  expandedSize += buffer.readUInt32LE(i + 24);
  entryCount++;
}
if (expandedSize > 20 * 1024 * 1024 || entryCount > 1000) {
  throw new Error("Belgenin açılmış boyutu çok büyük.");
}
Bu kısmı AI ajanı ilk seferde önermedi — "dosya boyutunu kontrol et" dediğimde sadece yüklenen dosyanın (sıkıştırılmış) boyutuna bakan bir kod yazdı. Zip-bomb riskini ben fark edip ayrıca sordum. Bu, AI ajanlarıyla çalışırken öğrendiğim en önemli derslerden biri: bilmediğiniz bir saldırı türünü AI'ya sormazsanız, AI de size söylemiyor.
3. Dış API yanıtlarına kör güvenmemek
Bir dış servisten (ödeme sağlayıcı, SMS servisi, üçüncü taraf API) gelen yanıtı doğrudan kullanmak, göründüğünden daha riskli. Servis bir gün yanıt şeklini değiştirebilir, beklenmedik bir hata döndürebilir ya da (daha kötüsü) ele geçirilmiş olabilir.
Bu yüzden dış servislerden gelen her yanıtı şema doğrulaması (schema validation) ile kontrol ediyorum — zod kullanarak. Beklenen alanlar yoksa, tipler uymuyorsa, uygulama sessizce yanlış veriyle devam etmek yerine açıkça hata veriyor.
const schema = z.object({
  status: z.enum(["success", "failed"]),
  amount: z.number().positive(),
});
const parsed = schema.safeParse(await response.json());
if (!parsed.success) throw new Error("Sağlayıcı geçersiz bir yanıt döndürdü.");
Bu, PlusTurk'teki ödeme entegrasyonlarında da uyguladığım bir prensip: sanal POS sağlayıcısından gelen "ödeme başarılı" bilgisini asla ham haliyle işlemeyin.
4. Rate limiting — CPU'yu tüketen istekleri sınırlamak
AI Check'in metin analizi CPU üzerinde çalışıyor (yerel istatistiksel model, dış servise istek atmıyor). Bu, maliyet açısından güzel ama farklı bir risk doğuruyor: biri saniyede yüzlerce istek atarsa sunucu kaynaklarını tüketebilir.
Uyguladığım basit ama etkili kural: IP başına 10 dakikada 5 istek, sunucu başına aynı anda en fazla 3 eşzamanlı analiz. Bu sınırlar, tek bir kötü niyetli kullanıcının sistemi kilitlemesini engelliyor ama gerçek kullanıcıları etkilemiyor.
if (entry.count >= 5 || inFlight >= 3) {
  throw new CheckError("İstek sınırına ulaşıldı. Birkaç dakika sonra tekrar deneyin.", 429);
}
Küçük bir not: Bu, tek sunucu örneği için yeterli ama birden fazla sunucuya yatay ölçeklendiğinizde (horizontal scaling) paylaşılan bir rate limit deposu (Redis gibi) gerekir — her sunucu kendi sayacını tutarsa, toplam limit sunucu sayısı kadar katlanır.
5. Girdiyi asla güvenli varsaymamak
Kullanıcıdan gelen her veri — dosya adı, form alanı, URL, hatta dosyanın kendisi — potansiyel olarak kötü niyetli kabul edilmeli. Pratikte bu şu anlama geliyor:
- Dosya uzantısına değil, gerçek içeriğine (magic bytes) bakarak doğrulama yapmak. Birisi
.pdfuzantılı bir dosya yükleyebilir ama içeriği PDF olmayabilir. - Her isteğin
Content-Lengthbaşlığına güvenmeden, gerçek veri akışını (stream) okurken boyutu saymak — başlık yalan söyleyebilir. - Aynı kaynaktan (origin) gelmeyen isteklerin formları işlememesini sağlamak (temel bir CSRF önlemi).
if (buffer.subarray(0, 5).toString() !== "%PDF-") {
  throw new Error("Bu dosya gerçek bir PDF değil.");
}
AI ajanlarına güvenmediğim yerler
Bu kadar örnekten sonra şunu netleştirmek istiyorum: AI ajanları bu güvenlik önlemlerinin hiçbirini kendiliğinden önermedi. Her birini ben sordum, ben tehdit modelini kurdum, AI da uygulamada yardımcı oldu. Somut olarak güvenmediğim üç şey:
- "Bu güvenli mi?" sorusuna verilen cevap. AI ajanları genellikle kendinden emin bir "evet, bu yaklaşım güvenlidir" cevabı verir — bu bir doğrulama değil, bir tahmin. Güvenlik kritik kodu her zaman kendim veya bir güvenlik araç zinciriyle (linter, statik analiz) ayrıca kontrol ediyorum.
- Varsayılan olarak "izin ver" eğilimi. AI'dan bir API yazmasını istediğinizde, genellikle en az dirençli yolu seçer — çoğu zaman bu, gereğinden fazla izin veren bir yapıdır. Yetkilendirmeyi her zaman "varsayılan olarak reddet, açıkça izin ver" mantığıyla ben kuruyorum.
- Bilmediğim bir saldırı sınıfını fark etmesi. Yukarıdaki zip-bomb örneğinde olduğu gibi, sormadığınız bir tehdidi AI de düşünmüyor. Bu yüzden OWASP Top 10 gibi listeleri düzenli olarak kendim gözden geçirip, "bu özellik için bunlardan hangisi geçerli olabilir?" diye soruyorum.
Pratik kontrol listesi
Yeni bir özellik — özellikle dış girdi alan bir özellik — geliştirirken AI ajanıyla birlikte çalışırken kendime sorduğum sorular:
- Bu özelliğe kim, nasıl kötüye kullanabilir sorusunu AI'ya mı sordum, yoksa doğrudan kod mu istedim?
- Dış bir kaynaktan (URL, dosya, API yanıtı) gelen veriyi içeriğine göre mi, yoksa sadece adına/uzantısına/başlığına göre mi doğruluyorum?
- Bir kaynak sınırı (dosya boyutu, istek sayısı, bellek) açıkça tanımlı mı, yoksa "yeterince büyük olur" varsayımıyla mı bırakıldı?
- Bu kodu, "normal kullanıcı" değil "kötü niyetli kullanıcı" gözünden bir kez daha okudum mu?
- AI'nın "bu güvenlidir" demesini, gerçek bir doğrulama (test, linter, manuel inceleme) olmadan kabul ettim mi?
Sonuç
AI ajanları, güvenlik kodunu yazma hızını ciddi şekilde artırıyor — ama güvenlik düşüncesini değil. Tehdit modelini kurmak, "bu nasıl kötüye kullanılır" sorusunu sormak ve AI'nın ilk önerisini sorgulamak hâlâ insana ait bir iş. AI Check'i geliştirirken edindiğim en net ders şu: AI'yı bir güvenlik uzmanı gibi değil, hızlı ama deneyimsiz bir yardımcı geliştirici gibi muamele edin — işi yapar, ama arkasından kontrol etmeniz gerekir.